Ocultar matrículas com IA no auto.moto.pt
Da luz verde do responsável pelo produto à produção em 33 horas: uma IA nossa oculta matrículas no auto.moto.pt.
No início de outubro, o responsável pelo produto do nosso próprio marketplace, o auto.moto.pt(abre num novo separador), pediu algo simples de enunciar: que o formulário do anúncio ocultasse a matrícula nas fotografias dos vendedores. Contamos como passámos desse pedido à produção, com um modelo nosso, e o que mostram os primeiros dias de uso.
O problema
Um anúncio de carro usado precisa de boas fotografias, e uma boa fotografia de um carro de frente ou de trás mostra a matrícula. Muitos vendedores não a querem pública: das 1450 fotografias que anotámos depois, 237 já tinham uma matrícula ocultada pelo vendedor, com um autocolante antes de fotografar ou, muito mais vezes, num editor de imagem. Muitos outros esquecem-se. As fotografias apanham ainda matrículas de carros estacionados ao lado, de pessoas que nunca aceitaram aparecer num anúncio.
A primeira resposta foi uma ferramenta manual: em cada fotografia do formulário, um botão abre um editor onde o vendedor marca a matrícula e esta fica coberta por quadrados grandes. Funciona, mas é mais um passo por fotografia, e o responsável pelo produto foi claro: o objetivo era ter menos cliques, não mais. A verdadeira pergunta passou a ser outra: o formulário consegue encontrar a matrícula sozinho?
Porque não usámos um modelo pronto
Começámos por testar um detetor de matrículas aberto, localmente, em 30 fotografias de capa da página inicial. Encontrou a matrícula em 17 das 18 fotografias onde havia uma visível. Também encontrou «matrículas» em tabliers e puxadores de portas, e tratou as placas dos stands como matrículas. Isso exclui a ocultação automática: nenhum vendedor quer um mosaico no conta-quilómetros. Havia um segundo problema: a licença dos pesos do modelo não estava indicada.
Escolhemos por isso o YOLOX-tiny, um detetor pequeno de código aberto, com código e pesos sob a licença Apache-2.0, e treinámo-lo com fotografias dos nossos próprios anúncios. As fotografias e o modelo nunca saíram da nossa infraestrutura.
Construir o conjunto de dados
A anotação começou com o detetor a propor caixas e cada fotografia a ser revista uma a uma: mover uma caixa, apagar uma caixa numa placa de stand, acrescentar uma matrícula que faltava. O primeiro conjunto tinha 512 fotografias de 195 anúncios. Entre elas havia 154 matrículas reais, em 132 fotografias. As restantes estavam lá de propósito: 141 interiores e 82 fotografias com placas de stands, para o modelo aprender o que não deve cobrir.
Cerca de 25 fotografias não cabiam numa regra simples, e cada grupo foi decidido com o responsável pelo produto: matrículas decorativas ou soltas, placas com o nome da marca, matrículas que o vendedor já tinha ocultado, matrículas vistas quase de perfil e matrículas minúsculas e ilegíveis ao fundo. A regra ficou assim: cobrir matrículas reais e legíveis, incluindo as de carros alheios; não mexer no que já está oculto ou não tem nada para esconder.
Treino e validação
O primeiro modelo foi testado em 50 fotografias que nunca tinha visto. Encontrou a matrícula do carro principal em 10 de 11, tal como o modelo pronto, mas com metade das caixas falsas (0,10 por fotografia contra 0,20) e só 2 coberturas indevidas em 8 fotografias com placas de stands, contra 8 em 8. Num núcleo de processador demora 0,15 segundos por fotografia, e o ficheiro do modelo tem 20 MB.
Também nos perguntaram se o OpenCV clássico resolveria o problema sem rede neuronal. Medimo-lo nas mesmas 50 fotografias, com a configuração afinada no conjunto de treino: procurar retângulos com a forma de uma matrícula encontrou 3 de 11 matrículas principais. Uma matrícula real está inclinada, tem reflexos, moldura ou fica parcialmente tapada, e só 8 das 15 matrículas de teste chegaram a dar um retângulo limpo.
O ponto fraco do primeiro modelo eram as matrículas pequenas ao fundo: 1 de 4. A solução foi ter mais dados, não mais engenho. Juntámos 938 fotografias de 573 anúncios, todas revistas, o que levou as fotografias de treino com matrículas reais de 109 para 409. O treino correu de noite nos processadores comuns do nosso próprio servidor e levou 3 horas e 15 minutos. Para os números serem honestos, criámos um segundo conjunto de teste com 86 fotografias de outros vendedores e 56 matrículas, e mantivemos as 50 fotografias antigas sem alterações, para comparar em pé de igualdade.
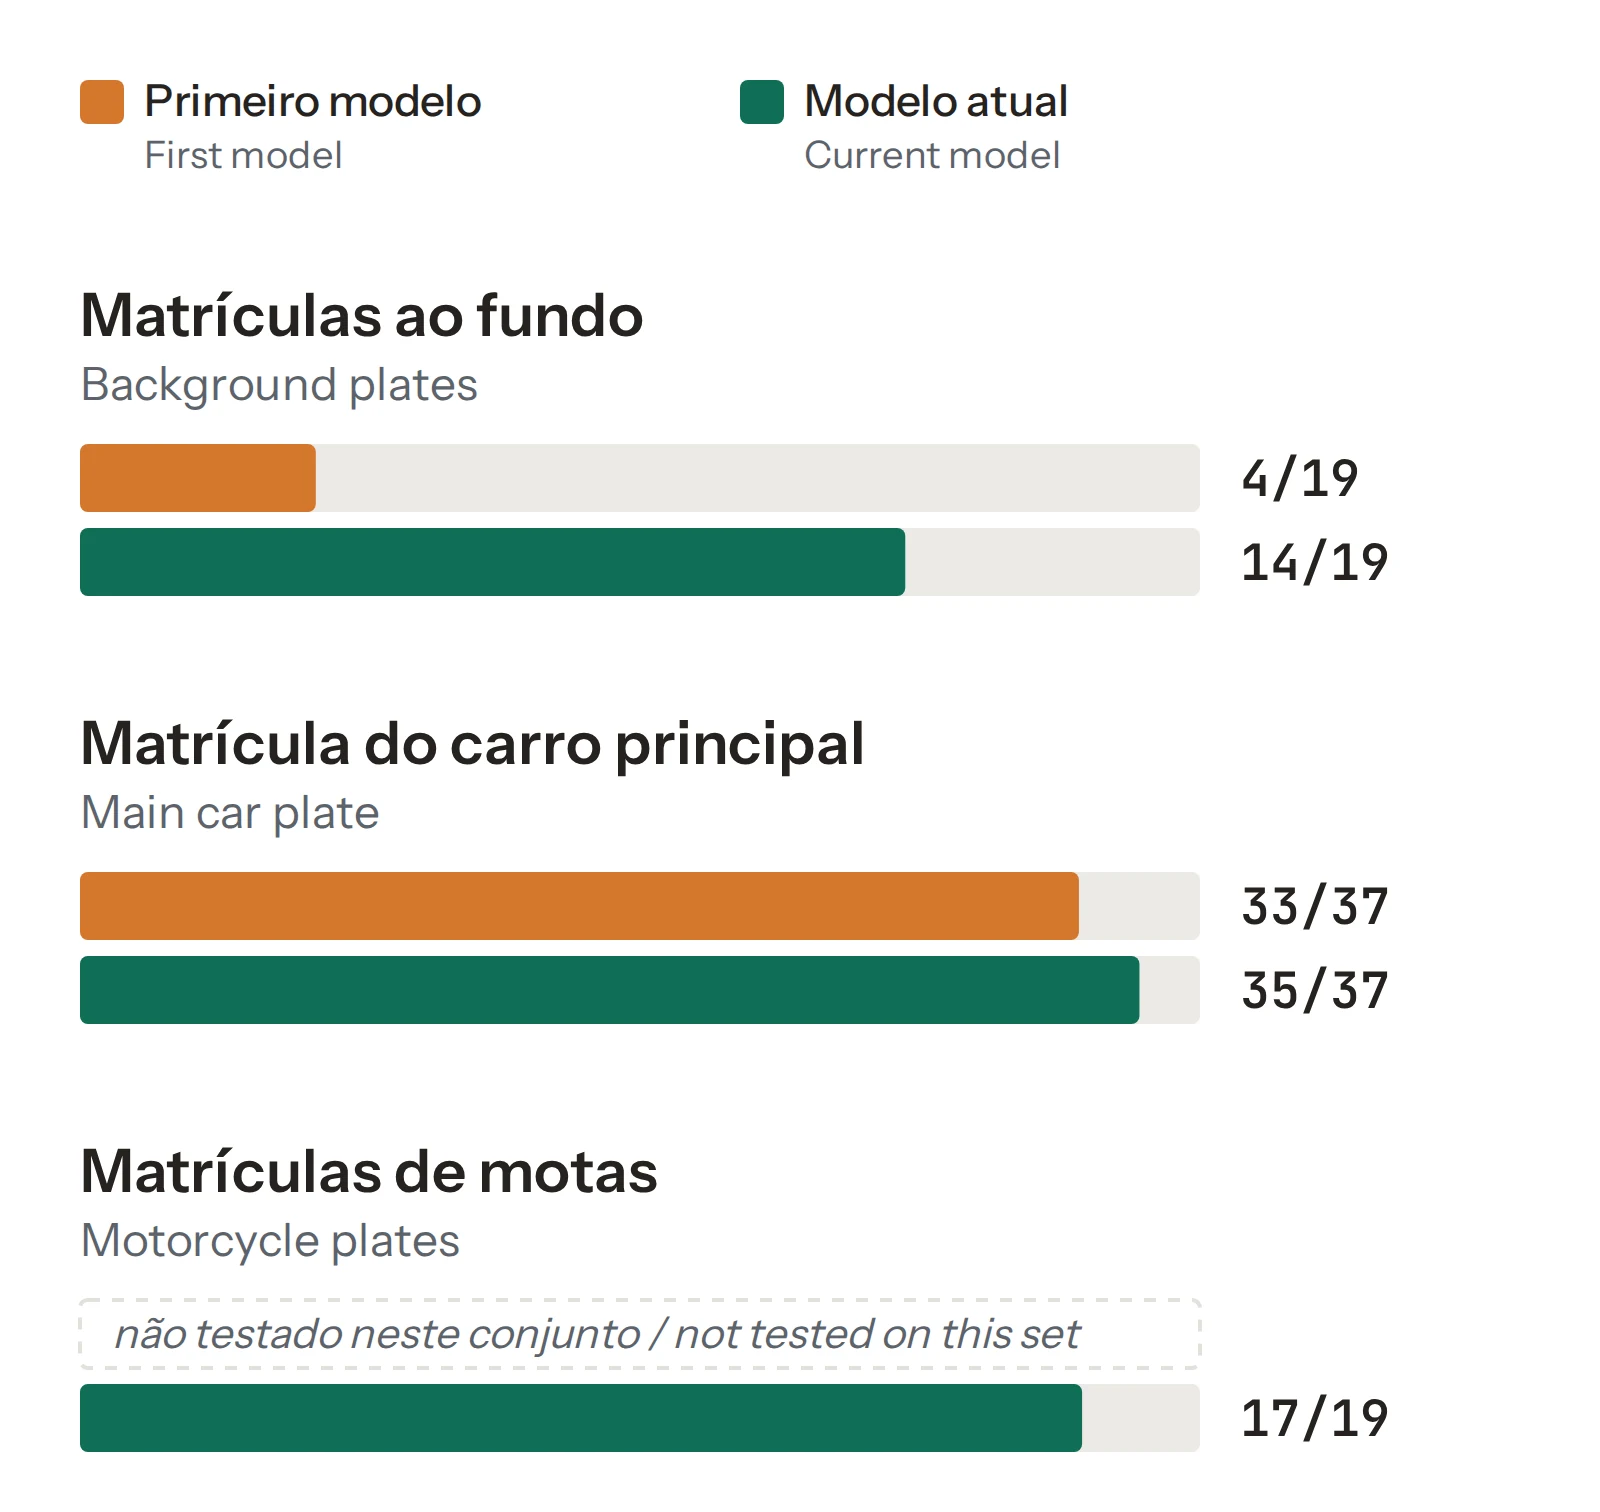
No novo conjunto de teste, a matrícula do carro principal passou de 33 de 37 para 35 de 37. Escolhemos uma sensibilidade mais baixa, que manteve estes resultados. O preço é um pouco mais de ruído do que no primeiro modelo: 0,07 caixas falsas por fotografia, cerca de uma em cada catorze, nenhuma sobre uma matrícula legível. Além disso, ainda volta a cobrir 8 das 11 matrículas que os vendedores já tinham ocultado, o que a terceira ronda de treino devia corrigir. Uma segunda verificação independente repetiu toda a avaliação com um script próprio, e os números bateram certo.
Cobrir a matrícula, não o carro
A primeira versão no site de testes desenhava um retângulo alinhado com a imagem à volta de cada matrícula e juntava-lhe uma margem. Num carro fotografado em ângulo, a matrícula é uma faixa inclinada e o retângulo alinhado com a imagem à volta dela é sobretudo carroçaria, e o mosaico parecia muito maior do que a matrícula. A correção acabou por usar o OpenCV: dentro da caixa do detetor, uma procura clássica de arestas encontra o contorno da própria matrícula, e só essa forma é coberta. Quando o contorno levanta dúvidas, cobre-se a caixa inteira, como antes.
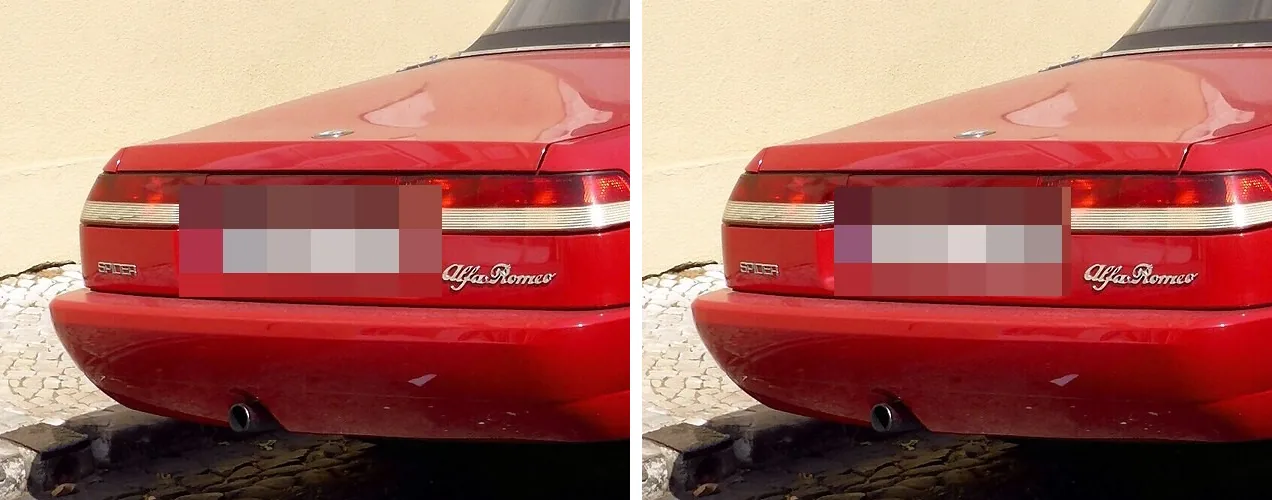
Os quadrados são grandes, e o seu tamanho é calculado a partir da própria matrícula. Antes do lançamento, uma segunda verificação independente passou 131 fotografias de anúncios recentes pelo site de testes: de frente, de trás, motas, ao anoitecer. Em nenhuma ficou legível uma única letra da matrícula, e as fotografias sem matrícula ficaram iguais.
Como entra no formulário do anúncio
No passo das fotografias há uma única caixa de seleção: «Ocultar a matrícula com inteligência artificial». Vem desligada por omissão, por decisão do responsável pelo produto. Quando está ligada, cada fotografia carregada passa por um pequeno serviço de deteção dentro do nosso próprio cluster, e a matrícula é coberta antes de a fotografia ser guardada, por isso, nos carregamentos novos, o original por cobrir nunca chega ao disco. Para as fotografias carregadas antes, o formulário de edição tem a mesma opção: uma cópia coberta substitui cada fotografia no anúncio.
Nada neste percurso pode bloquear um carregamento. Se o detetor estiver ocupado, lento ou em baixo, a fotografia é guardada tal como chegou, e o formulário avisa e indica o botão manual dessa fotografia.
Resultados em números
Desde a decisão de treinar um modelo próprio até à funcionalidade em produção passaram cerca de 33 horas: o primeiro modelo ficou pronto na mesma tarde, o melhorado nessa noite, e o site entrou em produção na noite de 7 de outubro.
Nos primeiros dias, até 10 de outubro, os vendedores publicaram cerca de 80 anúncios novos através do formulário (sem contar importações de feeds nem contas da equipa). Em 18 deles, cerca de um em cada cinco, há pelo menos uma fotografia coberta pela IA. É um valor mínimo: um anúncio com a opção ligada em que não se encontrou matrícula não deixa rasto. Seis anúncios mais antigos também tiveram a opção ligada no formulário de edição. No total, foram cobertas automaticamente 73 fotografias em 24 anúncios de 21 vendedores.
O que aprendemos
Os dados valem mais do que a afinação. O maior ganho, nas matrículas ao fundo, veio de anotar mais matrículas reais, não de mudar o modelo.
Os exemplos negativos são metade do trabalho. Foram os interiores e as placas dos stands que tornaram aceitável a ocultação automática.
Um modelo mais novo nem sempre é melhor. Uma terceira ronda de treino, que deixou de tratar as matrículas já ocultas como alvo e juntou motas, deu menos caixas falsas mas encontrou 46 das 56 matrículas de teste, contra 49 do modelo em produção. Fica de fora até ser melhor no que mais importa.
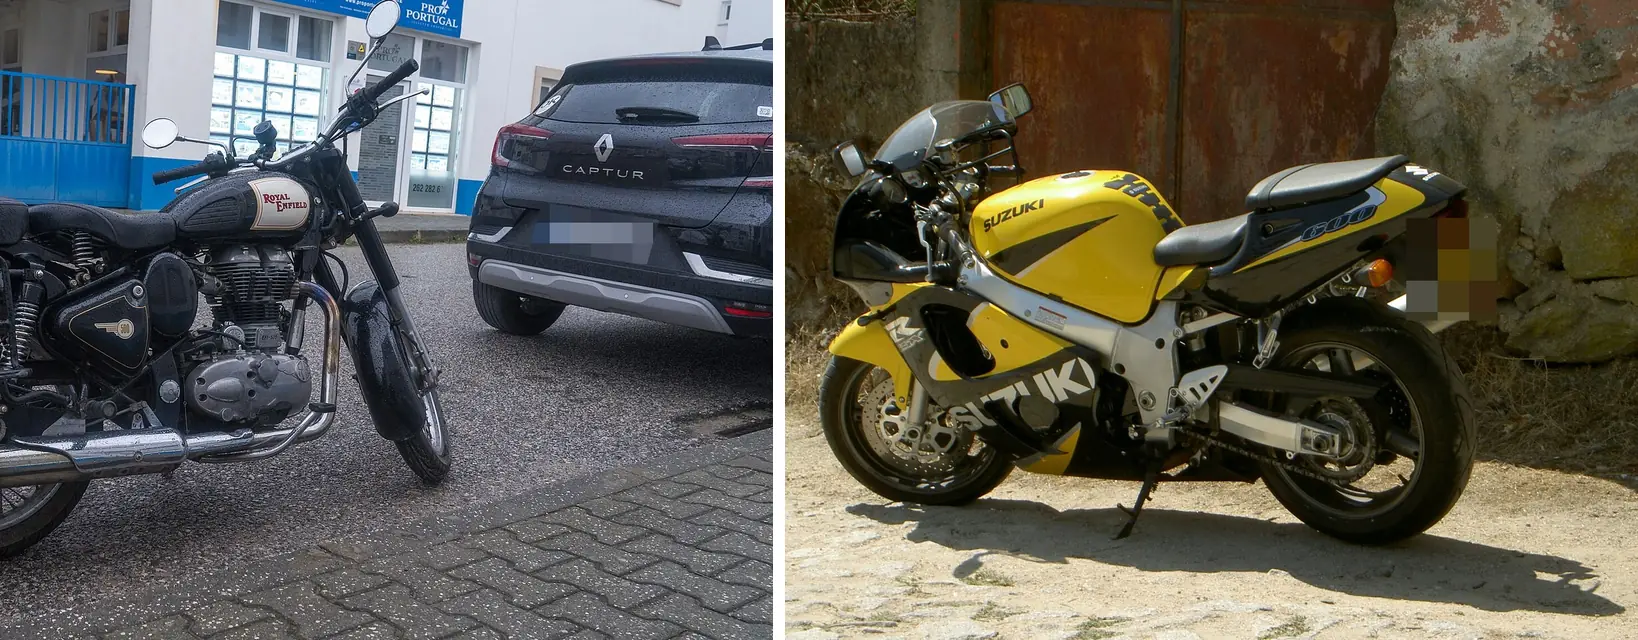
As matrículas pequenas ao fundo continuam a ser o caso mais fraco, com 14 de 19. As matrículas quadradas das motas saem-se melhor, e o modelo em produção encontra 17 de 19 num conjunto separado de fotografias de motas. A mesma opção já está construída na aplicação móvel, que ainda está em testes.
Se o seu produto lida com fotografias, documentos ou outros dados que exigem cuidado, é este o tipo de trabalho que fazemos para clientes em desenvolvimento de software à medida.